Sipeng Zheng

I build foundation models that let humanoid robots learn from how humans see and act. I’m a Partner at BeingBeyond, where I lead embodied multimodal pretraining and work with Prof. Zongqing Lu toward general-purpose humanoid robots. Our research spans the Being-H, Being-M, and Being-VL series — embodied foundation models, learning from egocentric human videos, large multimodal models, and humanoid robotics.

Before joining BeingBeyond, I was a researcher at the Beijing Academy of Artificial Intelligence (BAAI). I received both my Ph.D. and bachelor’s degree from Renmin University of China, advised by Prof. Qin Jin.

Portrait of Sipeng Zheng
Beijing, China

Research interests

  • Embodied foundation models
  • Vision-language-action models
  • Learning from egocentric video
  • Humanoid robotics
  • Large multimodal models

01

News

  1. We introduce TactoHand, which predicts dense hand-surface contact, proximity, and 3D force fields from video.

  2. Being-H0.7 is accepted to NeurIPS 2026.

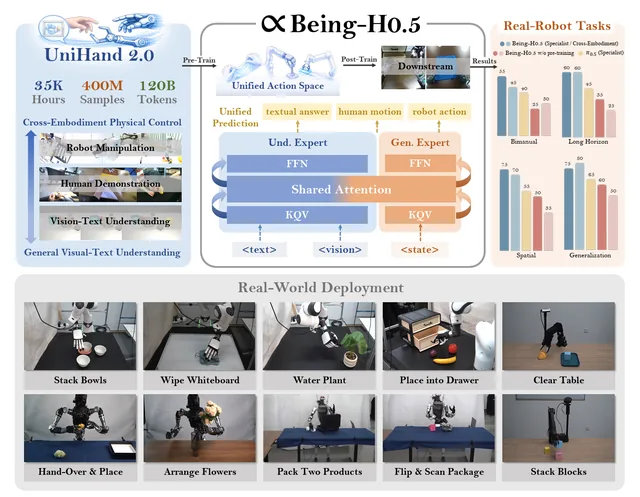
  3. Being-H0.5 is accepted to CoRL 2026 as an Oral presentation (21 orals selected from 2,094 submissions, ~1%).

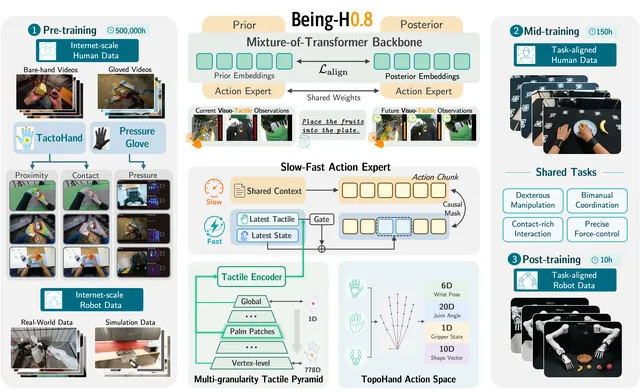
  4. We introduce Being-H0.8, a latent tactile world-action model at scale for contact-rich robot manipulation.

  5. One paper is accepted to ACM MM 2026.

  6. Three papers are accepted to ECCV 2026.

  7. Being-H0 is accepted to ICML 2026.

  8. We present Being-H0.7, a latent world-action model based on 200K human videos.

Earlier news9
  1. Being-H0.5 has been open-sourced.

  2. Three papers are accepted to CVPR 2026.

  3. We release Being-H0.5, our latest cross-embodiment foundation VLA.

  4. Two papers are accepted to NeurIPS 2025.

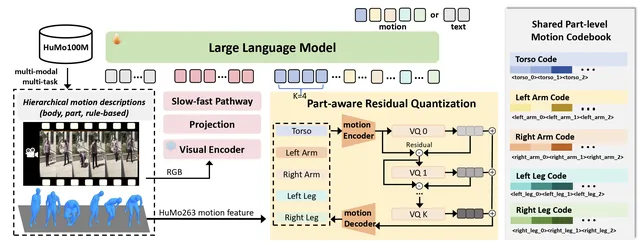
  5. We present Being-M0.5, an improved version of Being-M0 with real-time controllability.

  6. Our next-generation LMM, Being-VL-0.5, is released with code and checkpoints.

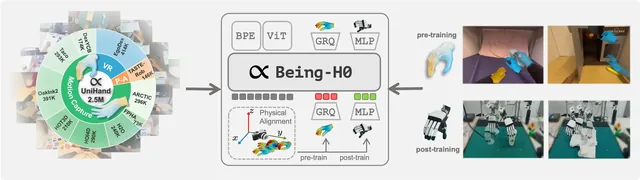
  7. We release Being-H0, the first VLA pretrained from large-scale human videos with hand motion.

  8. Three papers are accepted to ICCV 2025.

  9. We present our first million-level motion model, Being-M0, which is accepted to ICML 2025.

02

Research

Model series I lead at BeingBeyond.

03

Publications

Bold marks me; * denotes equal contribution.

2026

  1. TactoHand: Learning Geometry-Based Dense Hand-Surface Interaction Fields from Video

    Ziheng Xi, Weibo Li, Jiayi Yu, Sipeng Zheng, Wanpeng Zhang, Haiweng Xu, Hao Luo, Chuan Mao, Zongqing Lu

    arXiv 2026Paper
  2. Human-Centric Transferable Tactile Pre-Training for Dexterous Robotic Manipulation

    Chi Zhang, Penglin Cai, Ziheng Xi, Haoqi Yuan, Hao Luo, Wanpeng Zhang, Sipeng Zheng, Chaoyi Xu, Zongqing Lu

    arXiv 2026Paper
  3. Conservative Offline Robot Policy Learning via Posterior-Transition Reweighting

    Wanpeng Zhang, Hao Luo, Sipeng Zheng, Yicheng Feng, Haiweng Xu, Ziheng Xi, Chaoyi Xu, Haoqi Yuan, Zongqing Lu

    arXiv 2026Paper
  4. Rethinking Visual-Language-Action Model Scaling: Alignment, Mixture, and Regularization

    Ye Wang*, Sipeng Zheng*, Hao Luo*, Wanpeng Zhang*, Haoqi Yuan, Chaoyi Xu, Haiweng Xu, Yicheng Feng, Mingyang Yu, Zhiyu Kang, Zongqing Lu, Qin Jin

    arXiv 2026PaperBlogCode
  5. Robust Motion Generation using Part-level Reliable Data from Videos

    Boyuan Li, Sipeng Zheng, Bin Cao, Ruihua Song, Zongqing Lu

    ACM MM 2026Paper
  6. DiG-Flow: Discrepancy-Guided Flow Matching for Robust VLA Models

    Wanpeng Zhang, Ye Wang, Hao Luo, Haoqi Yuan, Yicheng Feng, Sipeng Zheng, Qin Jin, Zongqing Lu

    ECCV 2026PaperBlogCode
  7. RL from Physical Feedback: Aligning Large Motion Models with Humanoid Control

    Junpeng Yue, Zepeng Wang, Yuxuan Wang, Weishuai Zeng, Jiangxing Wang, Xinrun Xu, Yu Zhang, Sipeng Zheng, Ziluo Ding, Zongqing Lu

    ECCV 2026PaperProject
  8. Unmasking the Illusion of Embodied Reasoning in Vision-Language-Action Models

    Haiweng Xu, Sipeng Zheng, Hao Luo, Wanpeng Zhang, Ziheng Xi, Zongqing Lu

    ECCV 2026PaperCode
  9. Joint-Aligned Latent Action: Towards Scalable VLA Pretraining in the Wild

    Hao Luo, Ye Wang, Wanpeng Zhang, Haoqi Yuan, Yicheng Feng, Haiweng Xu, Sipeng Zheng, Zongqing Lu

    CVPR 2026Paper
  10. OpenT2M: No-frill Motion Generation with Open-source, Large-scale, High-quality Data

    Bin Cao, Sipeng Zheng, Hao Luo, Boyuan Li, Jing Liu, Zongqing Lu

    CVPR 2026Paper
  11. Spatial-Aware VLA Pretraining through Visual-Physical Alignment from Human Videos

    Yicheng Feng, Wanpeng Zhang, Ye Wang, Hao Luo, Haoqi Yuan, Sipeng Zheng, Zongqing Lu

2025

  1. OpenMMEgo: Enhancing Egocentric Understanding for LMMs with Open Weights and Data

    Hao Luo, Zihao Yue, Wanpeng Zhang, Yicheng Feng, Sipeng Zheng, Deheng Ye, Zongqing Lu

    NeurIPS 2025Paper
  2. EgoDTM: Towards 3D-Aware Egocentric Video-Language Pretraining

    Boshen Xu, Yuting Mei, Xinbi Liu, Sipeng Zheng, Qin Jin

    NeurIPS 2025PaperCode
  3. Taking Notes Brings Focus? Towards Multi-Turn Multimodal Dialogue Learning

    Jiazheng Liu, Sipeng Zheng, Börje F. Karlsson, Zongqing Lu

    EMNLP 2025Paper
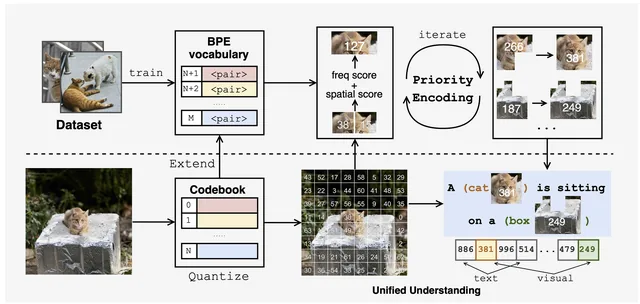
  4. Unified Multimodal Understanding via Byte-Pair Visual Encoding

    Wanpeng Zhang, Yicheng Feng, Hao Luo, Yijiang Li, Zihao Yue, Sipeng Zheng, Zongqing Lu

    ICCV 2025Highlight · 2.3%PaperBlogCodeProject
  5. Being-M0.5: A Real-Time Controllable Vision-Language-Motion Model

    Bin Cao*, Sipeng Zheng*, Ye Wang, Lujie Xia, Qianshan Wei, Qin Jin, Jing Liu, Zongqing Lu

  6. VideoOrion: Tokenizing Object Dynamics in Videos

    Yicheng Feng*, Yijiang Li*, Wanpeng Zhang, Sipeng Zheng, Zongqing Lu

    ICCV 2025Paper
  7. QuadrupedGPT: Towards a Versatile Quadruped Agent in Open-ended Worlds

    Yuting Mei*, Ye Wang*, Sipeng Zheng, Qin Jin

    arXiv 2025PaperProject
  8. Scaling Large Motion Models with Million-Level Human Motions

    Ye Wang*, Sipeng Zheng*, Bin Cao, Qianshan Wei, Weishuai Zeng, Qin Jin, Zongqing Lu

    ICML 2025PaperProject
  9. EgoNCE++: Do Egocentric Video-Language Models Really Understand Hand-Object Interactions?

    Boshen Xu, Ziheng Wang, Yang Du, Zhinan Song, Sipeng Zheng, Qin Jin

    ICLR 2025PaperCode
  10. From Pixels to Tokens: Byte-Pair Encoding on Quantized Visual Modalities

    Wanpeng Zhang, Zilong Xie, Yicheng Feng, Yijiang Li, Xingrun Xing, Sipeng Zheng, Zongqing Lu

    ICLR 2025PaperProject
  11. SPAFormer: Sequential 3D Part Assembly with Transformers

    Boshen Xu, Sipeng Zheng, Qin Jin

    3DV 2025PaperCode

2024

  1. UniCode: Learning a Unified Codebook for Multimodal Large Language Models

    Sipeng Zheng, Bohan Zhou, Yicheng Feng, Ye Wang, Zongqing Lu

    ECCV 2024Paper
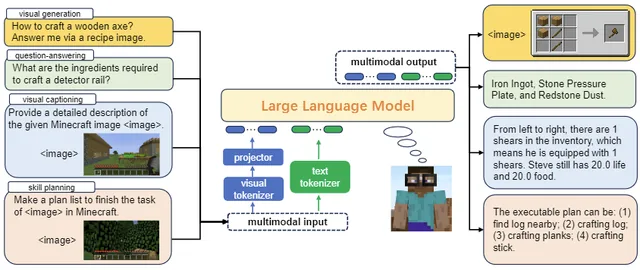
  2. Steve-Eye: Equipping LLM-based Embodied Agents with Visual Perception in Open Worlds

    Sipeng Zheng, Jiazheng Liu, Yicheng Feng, Zongqing Lu

    ICLR 2024Spotlight · 5.02%PaperProjectCode
  3. LLaMA Rider: Spurring Large Language Models to Explore the Open World

    Yicheng Feng, Yuxuan Wang, Jiazheng Liu, Sipeng Zheng, Zongqing Lu

    NAACL 2024PaperCode

2022

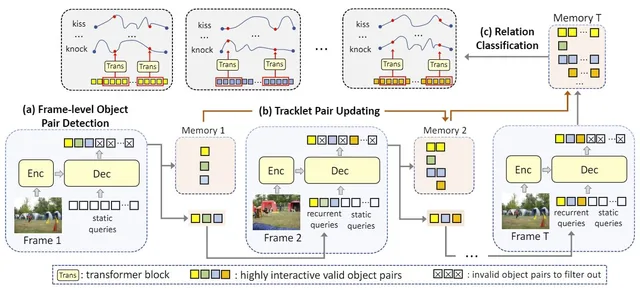
  1. VRDFormer: End-to-End Video Visual Relation Detection with Transformers

    Sipeng Zheng, Shizhe Chen, Qin Jin

    CVPR 2022Oral · 4.14%PaperCode
  2. Exploring Anchor-based Detection for Ego4D Natural Language Query

    Sipeng Zheng, Qi Zhang, Bei Liu, Qin Jin, Jianlong Fu

    CVPR 2022 WorkshopPaperCode

2019

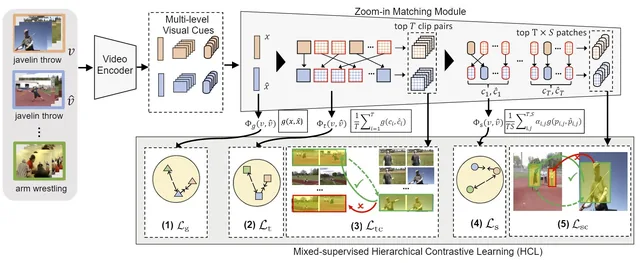
  1. Visual Relation Detection with Multi-Level Attention

    Sipeng Zheng, Shizhe Chen, Qin Jin

    ACM MM 2019Paper
  2. Relation Understanding in Videos

    Sipeng Zheng, Xiangyu Chen, Shizhe Chen, Qin Jin

    ACM MM 2019Paper

Google Scholar

04

Honors

Challenges & Competitions

  • 2025

    1st placeGemBench Challenge, CVPR 2025 Workshop GRAIL

  • 2022

    3rd placeEgo4D Natural Language Query Challenge, CVPR 2022

  • 2021

    3rd placeNIST TRECVID 2021 Ad-hoc Video Search (AVS) Challenge

  • 2021

    2nd placeHOMAGE Scene-graph Generation Challenge, CVPR 2021

  • 2020

    2nd placeVideo Relationship Understanding Grand Challenge, ACM MM 2020

  • 2019

    2nd placeVideo Relationship Understanding Grand Challenge, ACM MM 2019

  • 2019

    Best Method Prize, ACM MM 2019 Grand Challenge

  • 2015

    First Prize, National University Mathematical Modeling Competition (Beijing Area)

Scholarships

  • 2022

    National Scholarship for Ph.D. Students

  • 2018–21

    First Class Scholarship for Ph.D. Students

05

Experience

Work

  • 2025.05 – Present

    Research Scientist

    BeingBeyondBeijing, China

  • 2023.07 – 2025.05

    Researcher

    Beijing Academy of Artificial Intelligence (BAAI)Beijing, China

  • 2022.04 – 2022.10

    Research Intern

    Microsoft Research AsiaBeijing, China

  • 2021.11 – 2022.04

    Research Intern

    Beijing Academy of Artificial Intelligence (BAAI)Beijing, China

Education

  • 2018.09 – 2023.06

    Ph.D., Computer Science and Engineering

    Renmin University of ChinaAdvisor: Prof. Qin Jin

  • 2014.09 – 2018.06

    Bachelor's Degree, Computer Science and Engineering

    Renmin University of ChinaBeijing, China
Service

Conference Reviewer
  • CVPR
  • ICCV
  • ECCV
  • ACCV
  • NeurIPS
  • AAAI
  • ACM MM
Journal Reviewer
  • IJCV
  • TCSVT
  • TMM
  • JATS